[Elasticsearch] 내부 동작 과정에 대해 알아보자
Elasticsearch 개념
Elasticsearch란?
elasticsearch는 오픈소스 검색엔진인 apache lucene을 기반으로 동작하며
restful 인터페이스를 통해 검색 서비스를 제공한다.
인덱스
모든 데이터는 JSON 도큐먼트로 저장되는데 도큐먼트들의 논리적 집합을 인덱스라고 한다.
인덱스를 조회해보면 mappings, settings, aliases로 구성된다.
mappings는 데이터가 어떻게 저장되고 검색될지에 관한 스키마이고
settings는 데이터가 어떻게 물리적으로 저장되고 운영할지에 관한 설정이고
aliases는 인덱스의 별칭이다.
아래에서는 movies라는 인덱스를 조회하고 있다.
GET movies
{
  "alias": {},
  "mappings": {
    "properties": {
      "make": {
        "title": "text"
      }
    }
  },
  "settings": {
    "index": {
      "number_of_replicas": 3
    }
  }
}
역인덱스
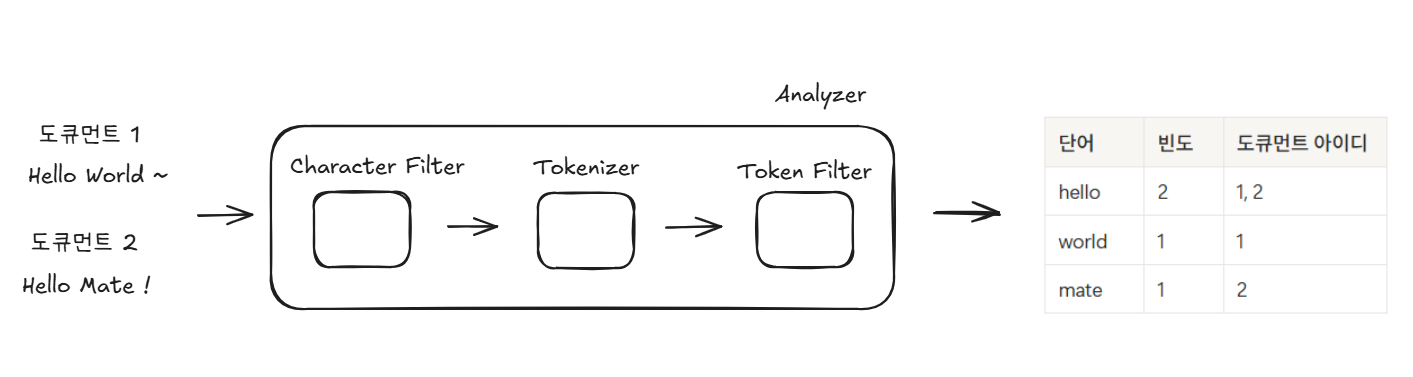
단어마다 해당 단어가 포함된 문서 목록을 저장한 자료구조로 검색을 빠르게 해준다.
text 타입의 단어는 불용어가 포함된 경우 필터링되고 토큰화 되어서
단어마다 빈도수와 단어가 포한된 문서 아이디를 저장하게 된다.
keyword 타입의 단어는 이런 분석 과정을 거치지 않고 하나의 단어로 취급되어서
단어마다 빈도수와 단어가 포한된 문서 아이디를 저장하게 된다.
전문 검색을 하면 관련성 점수를 계산해서 반환해준다.
관련성 점수를 계산하는 알고리즘은 TD-IDF, BM25가 있다.
TD-IDF는 단어가 문서에 많이 나올수록 점수를 높게 주고
단어가 전체 문서 집합에서 드물게 나타날 수록 점수를 높게 준다.
BM25는 단어가 문서에 많이 나올수록 점수를 높게 주지만 비선형 함수를 적용해서 점수의 상승폭을 줄였다.
또한 도큐먼트 길이 정규화를 적용해서 길이가 짧은 문서에서 단어가 발견될 수록 점수를 높게 준다.
이외에도 숫자 타입, 날짜 타입, 위치 정보 타입은 BKD 트리로 저장된다.
매핑
매핑은 도큐먼트의 필드들이 어떻게 저장되고 검색될지를 정하는 설정이다.
매핑은 2가지 방식이 있다.
정적 매핑은 사용자가 미리 데이터의 구조와 타입을 정의해서 매핑을 생성하는 것이다.
dynamic 옵션을 strict로 설정하면 미리 정의되지 않은 필드를 가진 도큐먼트를 저장할 때 에러가 발생한다.
기본적으로 이 옵션은 true로 새로운 필드를 가진 도큐먼트를 저장할 때
elasticsearch가 타입을 추론해서 매핑에 추가한다.
아래에서는 movies 인덱스를 생성할 때 title 필드를 정의하고 이후에 release_date 필드를 추가하고 있다.
# 인덱스 생성 API를 사용해서 인덱스 생성
PUT movies
{
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "title": {
        "type": "text"
      }
    }
  }
}
# 매핑 API를 사용해서 인덱스 업데이트
PUT movies/_mapping
{
"properties": {
"release_date": {
"type": "date",
"format": "dd-mm-yyyy"
}
}
}
동적 매핑은 미리 필드를 정의하지 않아도
elasticsearch가 데이터의 형태를 보고 자동으로 타입을 추론해서 매핑을 생성하는 것이다.
의도치 않은 타입으로 지정될 수 있기 때문에 운영환경에서 동적 매핑을 사용하지 않는 것이 권장된다.
인덱스는 한번 생성되면 기존 필드에 대한 수정이 불가하다.
다른 데이터 타입으로 변경하려면 다음 과정을 거쳐야한다.
1. 데이터 타입을 수정해서 새로운 인덱스를 생성한다.
2. reindexing API를 사용해서 이전 인덱스의 데이터를 새로운 인덱스로 복사한다.
아키텍처
노드
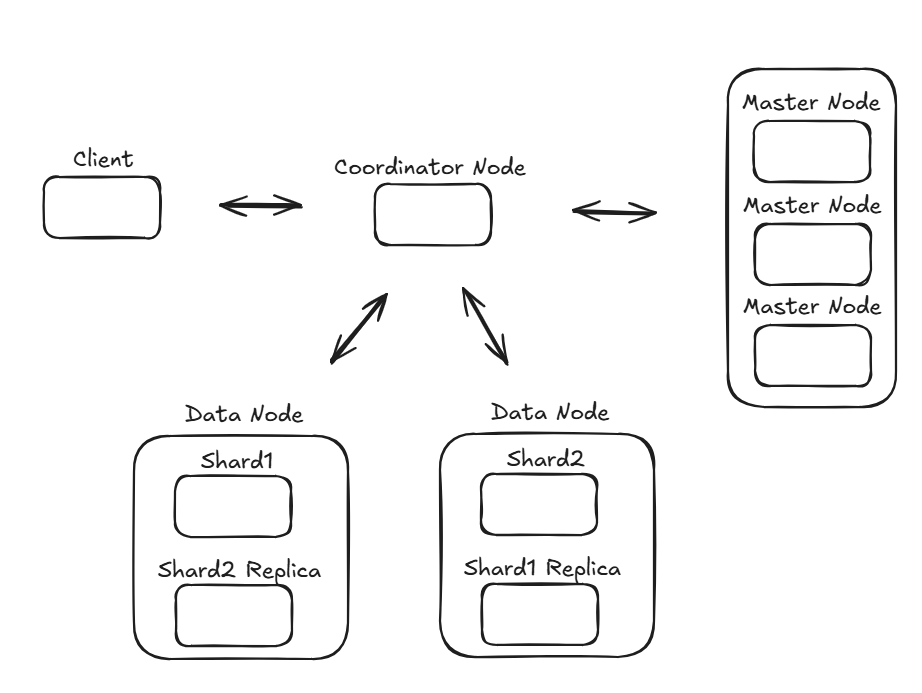
클러스터는 여러 노드로 구성되고
노드는 master 노드, data 노드, coordinator 노드로 분류된다.
노드의 역할은 elasticsearch.yml에서 node.roles로 정할 수 있다.
기본적으로 모든 노드는 coordinator 노드이다.
master 노드는 클러스터의 메타 데이터를 저장하고 있고
인덱스 생성/삭제, 샤드 할당/재배, 노드 추가/제거 작업을 수행한다.
운영환경에서는 3대로 구성하는 것이 권장된다.
data 노드는 데이터를 저장하고 있고
검색과 집계 작업을 수행한다.
cluster 내의 하나의 노드가 active coordinator로 선택되며
active coordinator 노드는 클라이언트의 요청을 받아서
해당 데이터를 가지고 있는 노드로 요청을 보내고
이후 받은 데이터를 병합하고 정렬해서 클라이언트에게 응답을 한다.
샤드
샤드는 물리적인 저장소로 primary 샤드, replica 샤드로 분류된다.
replica 샤드는 primary 샤드의 복제본으로
고가용성을 위해 primary 샤드와 다른 node에 배치하는 것이 권장된다.
replica 샤드를 통해 읽기 요청을 분산시킬 수 있고
primary 샤드가 속한 노드가 down될 경우 replica 샤드를 대신 사용할 수 있다.
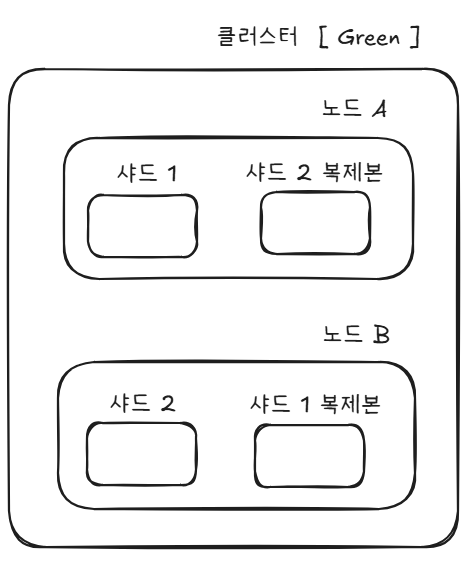
클러스터는 RED, YELLOW, GREEN 상태를 가질 수 있다.
RED는 샤드가 할당되지 않은 상태이고
YELLOW는 샤드가 할당되어있으나 복제본이 할당되지 않은 상태이고
GREEN은 샤드와 복제본이 할당되고 정상 동작중인 상태이다.
인덱스
인덱스 분할과 축소
인덱스에 데이터가 과부하되는 경우 검색 쿼리가 느려지거나 데이터 손실 위험이 생길 수 있다.
movies 인덱스가 5개의 샤드에 걸쳐서 저장되어있는데 과부하가 생긴다면
10개의 샤드를 가진 새로운 인덱스로 확장할 수 있는데 이를 인덱스 분할이라고 한다.
인덱스 분할을 하기위해서는 인덱스를 읽기 전용으로 변경하고 인덱스 분할 작업을 한다.
아래에서는 인덱스가 속한 샤드를 10개로 늘리고 있다.
# 읽기 전용으로 변경
PUT movies/_settings
{
  "settings": {
    "index.blocs.write": "true"
  }
}
# 인덱스 분할 API를 사용해서 인덱스 분할
POST movies/_split/new_movies
{
"settings: {
"index.number_of_shards": 10
}
}
인덱스 축소는 인덱스 분할과 반대 작업으로
더 적은 수의 샤드를 가진 새로운 인덱스로 축소하는 것을 가리킨다.
인덱스 축소를 하기 위해서 인덱스를 읽기 전용으로 변경하고
하나의 노드로 모아서 인덱스 축소 작업을 하고 다시 여러 노드로 재분산한다.
아래에서는 node-1이라는 노드로 인덱스를 모아서
해당 인덱스 속한 샤드를 5개로 축소한 뒤 다시 여러 노드로 재분산하고 있다.
# 읽기 전용으로 변경하고 여러 샤드를 하나의 노드로 모은다
PUT movies/_settings
{
  "settings": {
    "index.blocs.write": "true",
    "index.routing.allocation.require._name": "node-1",
  }
}
# 인덱스 축소 API 사용
POST movies/_shrink/new_movies
{
"settings": {
"index.number_of_shards": 5
}
}# 재분산
PUT new_movies/_settings
{
"settings": {
"index.blocks.write": null,
"index.routing.allocation.require._name": null
}
}
인덱스 수명 주기
인덱스는 다음과 같은 수명 주기 단계가 있다.
hot : 운영 모드로 인덱스의 읽기 작업과 쓰기 작업이 가능하다.
warm : 인덱스는 읽기 전용이고 비번한 쿼리를 허용한다.
cold : 인덱스는 읽기 전용이고 느린 쿼리를 허용한다.
frozen : 인덱스는 읽기 전용이고 매우 느린 쿼리를 허용한다.
delete : 인덱스가 삭제된다. 삭제 되기전에 shapshot으로 남기기 때문에 복원이 가능하다.
ILM은 인덱스 수명 관리로 수명 주기 정책을 관리하는 것을 말한다.
인덱스가 계속 커질 경우 정책을 정의해서 조건을 만족하면 새로운 인덱스로 rollover하도록 할 수 있다.
수명 주기 정책을 정의하고 인덱스에 연결한다.
아래에서는 min_age를 0ms로 두어서 바로 hot 단계에 진입하도록 했고
max_age, max_docs, max_size 조건을 두어서 하나라도 만족하면 rollover하도록 하고 있다.
# 인덱스 수명 주기 정책 정의
PUT _ilm/policy/movies_hot_policy
{
  "policy": {
    "phases": {
      "hot": {
        "min_age": "0ms",
        "actions": {
          "rollover": {
            "max_age": "1d",
            "max_docs": 1000,
            "max_size": "10gb"
          }
        }
      }
    }
  }
}
# 인덱스에 인덱스 생명 주기 정책 연결
PUT movies-0001
{
"settings": {
"index.lifecycle.name": "movies_hot_policy"
}
}
인덱스를 rollover 하기위해서 접미사에 숫자를 두어야한다.
rollover를 하면 접미사의 숫자가 증가하면서 인덱스가 생성된다.
movies-0001 movies-0002 ...
이때 별칭을 정의해서 rollover되는 인덱스를 하나의 이름으로 참조할 수 있다.
PUT movies-0001
{
  "alias": {
    "movies-alias": {
      "is_write_index": true
    }
  }
}